Monitoreo de servidores
Físicos y virtuales
CPU, memoria, disco y servicios
Windows, Linux, VMware y Hyper-V, con alertas predictivas de agotamiento.
Bases de datos
Conexiones, bloqueos y consultas lentas
SQL Server, MySQL, PostgreSQL y Oracle.
Ve en una sola consola lo que pasa en tus servidores, redes, aplicaciones y nube. Nuestro NOC detecta anomalías, anticipa fallas y te avisa con contexto antes de que tus usuarios levanten un ticket.
Un disco lleno, un enlace saturado o una API lenta pueden detener la facturación durante horas. Sin monitoreo de servidores y redes 24/7, el primer aviso llega por teléfono y el diagnóstico empieza a ciegas.
Te enteras de las fallas de red y caídas de servidor sólo cuando los usuarios finales levantan tickets o reclaman por teléfono.
Sin dashboards consolidados. Tu personal tiene que abrir consolas separadas para red, servidores, nube y virtualización, retrasando el diagnóstico.
Consolidación en una sola pantalla. Monitoreo unificado y alertas inteligentes configuradas para anticipar la degradación de recursos.
Integramos herramientas de observabilidad bajo un modelo unificado gestionado por ingenieros, con cobertura documentada por servicio.
Uso de CPU, memoria, almacenamiento, logs de servicios y salud física de servidores Linux y Windows (on-premise y multi-nube en AWS, Azure y Google Cloud).
Detección de latencia inusual, pérdida de paquetes y caídas de túneles VPN/SD-WAN. Soporte nativo para SNMP, ICMP y flujos NetFlow.
Monitoreo sintético y APM (Application Performance Monitoring) para medir transacciones SQL y APIs contra los SLO definidos para cada aplicación.
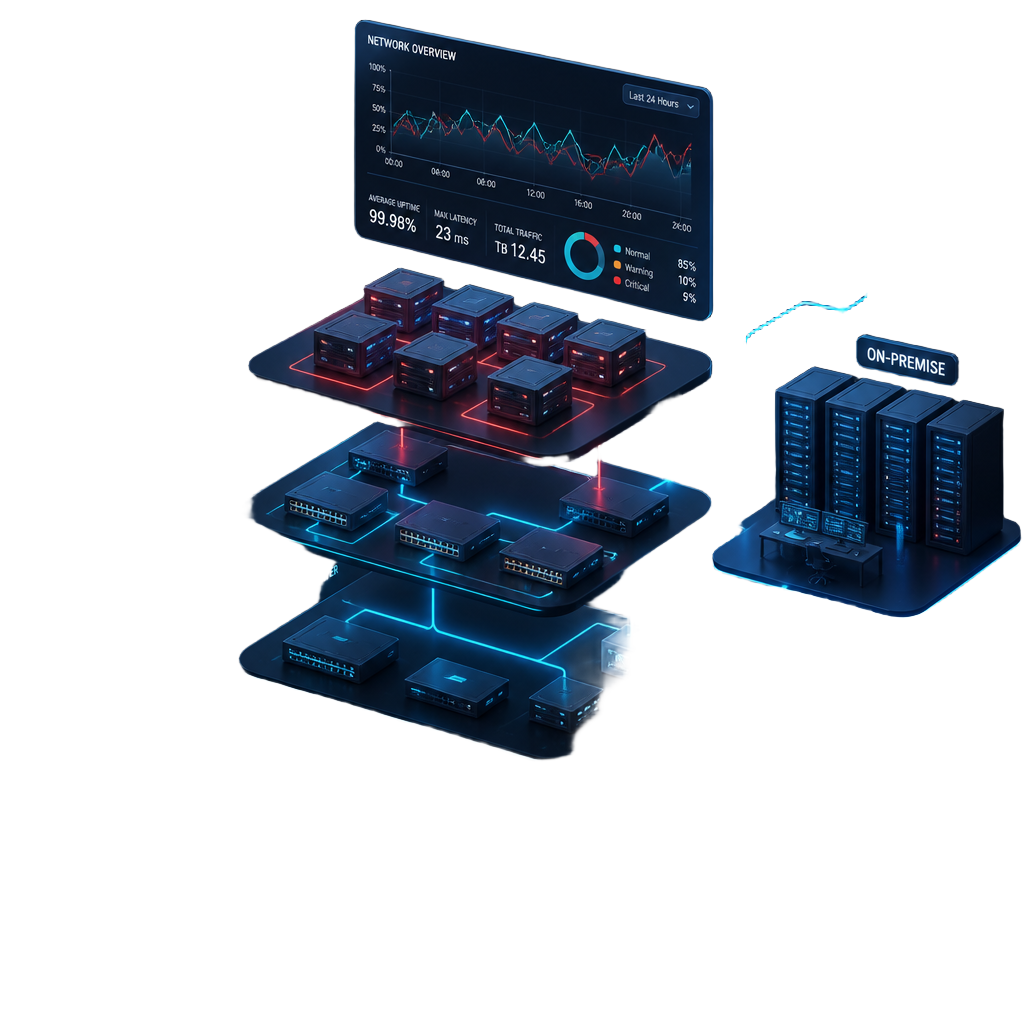
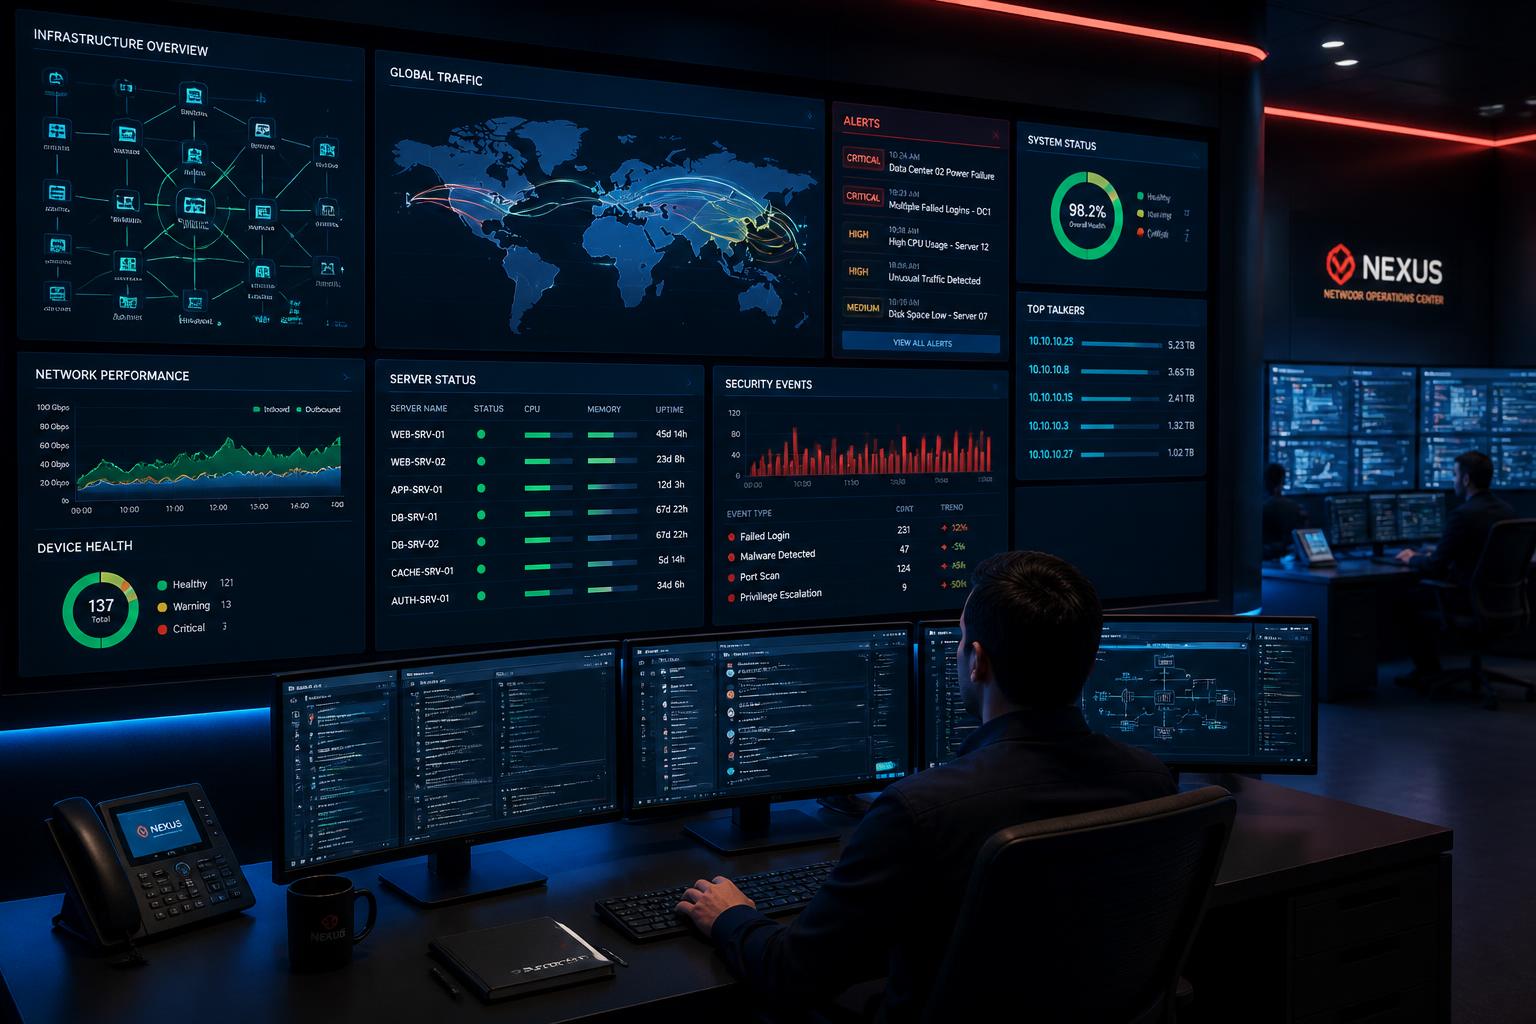
Una consola NOC ilustrativa. Cuatro perspectivas técnicas con datos sintéticos para mostrar las capacidades.
Servidor App vs Base de Datos · agregado por hora
Agenda una sesión express de 30 minutos para definir alcance, accesos y métodos de recolección. El diagnóstico prioriza los riesgos observados y confirma el calendario de entrega.
Activa un escenario sintético de anomalía y respuesta. Los tiempos y resultados ilustran el flujo; no representan telemetría productiva ni un SLA.
Acordamos la ventana inicial después del levantamiento y maduramos el esquema por fases, con cambios e interrupciones previstas documentados.
Mapeo exhaustivo de servidores, redes, aplicaciones y bases de datos críticas.
Despliegue ágil de agentes de monitoreo ligeros y configuraciones SNMP.
Diseño de pantallas personalizadas: métricas técnicas detalladas y KPIs ejecutivos.
Supresión de falsos positivos y configuraciones predictivas de agotamiento de recursos.
Revisión mensual de Uptime, rendimiento y entrega de métricas formales.
Es la supervisión continua de servidores, redes, almacenamiento, nube y aplicaciones para medir disponibilidad y rendimiento, detectar anomalías y avisar antes de que una falla llegue al usuario. En BITS lo operamos desde un NOC 24/7: tú recibes el diagnóstico, no solo la alerta.
Windows, Linux, VMware y Hyper-V, con alertas predictivas de agotamiento.
SQL Server, MySQL, PostgreSQL y Oracle.
Switches, firewalls, access points, disponibilidad, latencia y pérdida de paquetes.
Qué aplicación, usuario o sede consume el ancho de banda de tus enlaces WAN y SD-WAN.
Transacciones, APIs y dependencias de tus apps de negocio, con trazas para ubicar el cuello de botella.
Pruebas periódicas de ERP, portales y APIs desde distintas ubicaciones.
Instancias, contenedores y servicios gestionados en la misma consola que tu infraestructura local.
| Criterio | Monitoreo | Observabilidad |
|---|---|---|
| Pregunta que responde | ¿Está funcionando? | ¿Por qué está fallando? |
| Datos | Métricas y umbrales | Métricas, logs y trazas correlacionados |
| Ideal para | Disponibilidad y alertas | Diagnóstico de fallas complejas |
Combinamos ambos: monitoreo para enterarte a tiempo, observabilidad para resolver rápido.
Monitoreo open source de servidores y redes a gran escala.
Sensores listos para red, SNMP y tráfico en entornos medianos.
Dashboards de observabilidad que unen varias fuentes de datos.
APM, logs y métricas de nube en una plataforma SaaS.
Protocolos: SNMP, ICMP, NetFlow/sFlow, WMI, APIs y agentes ligeros. Si ya tienes una herramienta, la aprovechamos.
Partners y tecnologías que dominamos
Migraciones reales a arquitecturas modernas de red y seguridad — con resultados medibles desde la primera fase.
Servicios Administrados de red LAN/WAN y Seguridad Perimetral.
Integración tecnológica para un complejo comercial, hotelero y corporativo.
Seguridad y automatización para ambientes mineros exigentes.
Artículos seleccionados de nuestro blog para entender mejor la convergencia de red y seguridad en la nube.
Revisamos tus servidores, enlaces y aplicaciones críticas, identificamos puntos ciegos y te proponemos un esquema de monitoreo 24/7 a la medida de tu operación.
NDA disponible · Despliegue por fases con riesgo e impacto evaluados antes del cambio